生成モデルでビジュアル素材をひとそろい作るとき、いちばん失敗しやすいのは、1枚ごとに丁寧にプロンプトを書き直すやり方です。

どれだけうまく書いても、1枚ごとに少しずつずれていきます。同じことを毎回言葉で説明し直しているのですから、その説明が毎回同じになることはありません。

本当に効いた2つのこと

① スタイルの記述を固定する。光、色調、質感、コントラスト、レンズの表現をひとまとまりの文章にして、すべての画像で一字一句変えずに使います。画像ごとに書くのは、被写体の1文だけです。

② 参考画像で条件づける。色は言葉で説明せず、カラーパレットと既存の素材を入力の一部として渡します。言葉による色の説明は、いちばん不安定なところです。

この2つを変えてから、ずれ方は「毎回違う」から「ときどき1枚はじく」程度になりました。

繰り返すのは性質であって、形ではない

最初の版では、「光」のルールをかなり具体的に書いていました。その結果、数十枚のうち半分が同じ手法になってしまいました。

ひとそろいの素材というより、1つのフィルターに見えました。

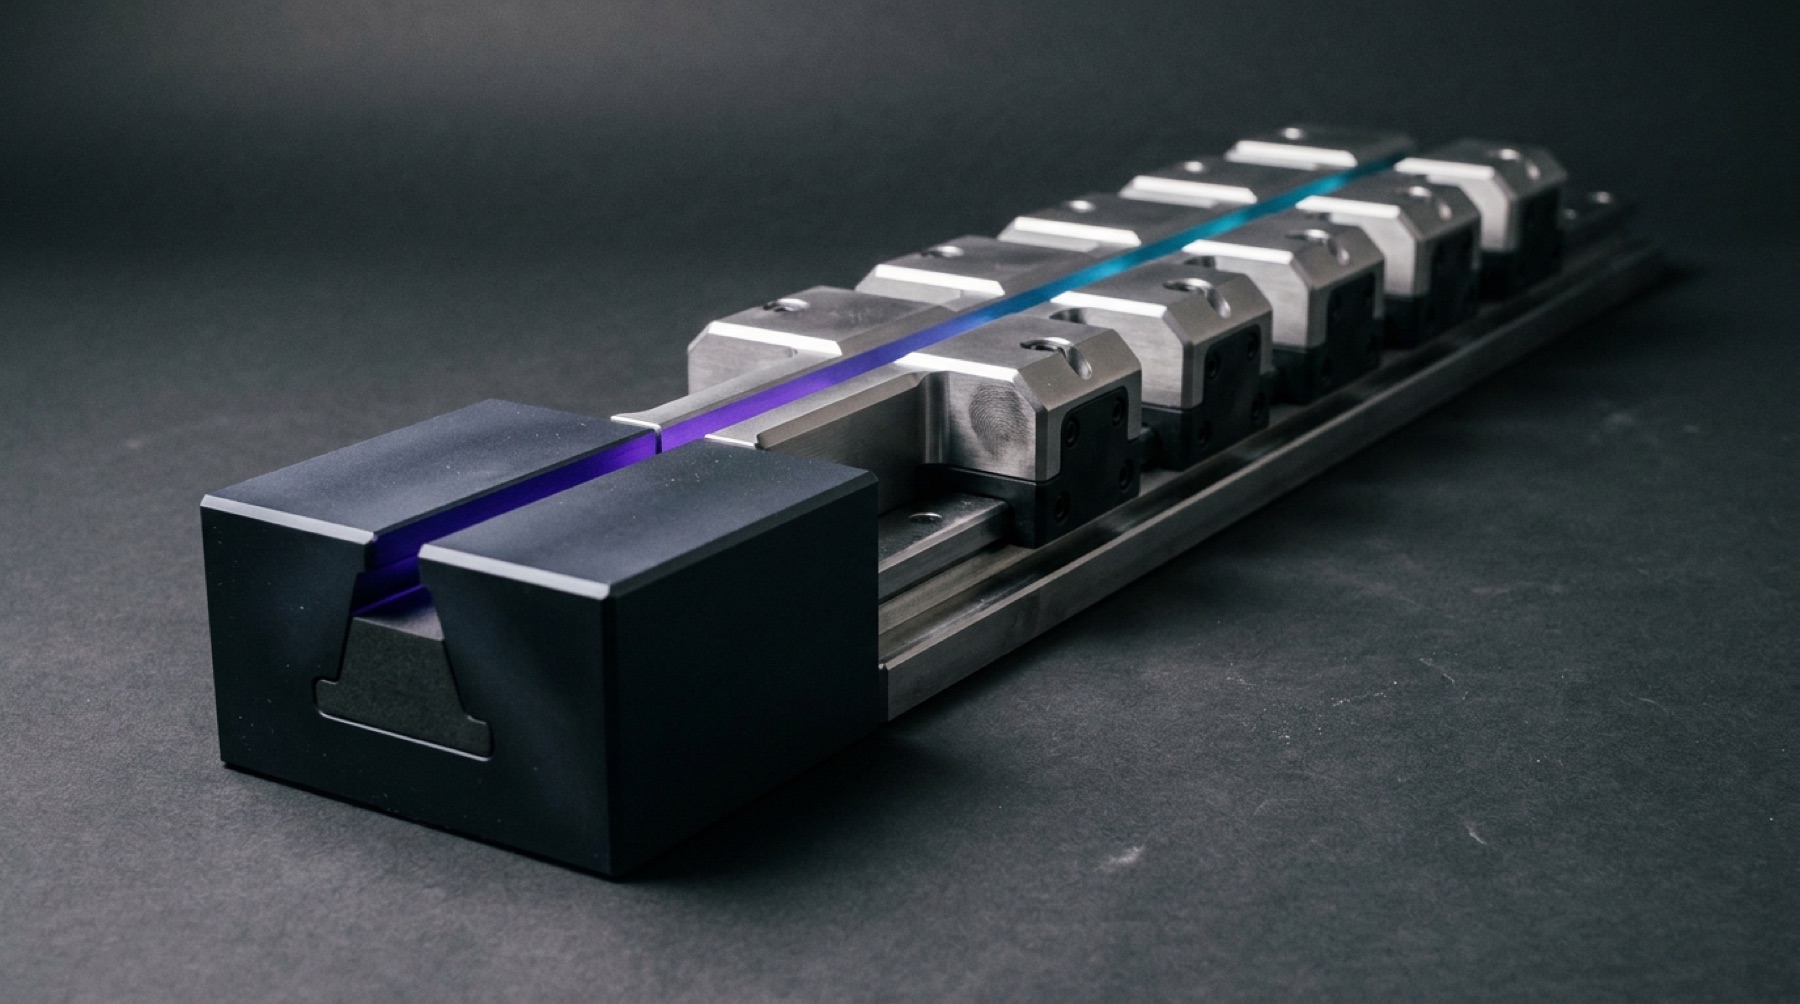
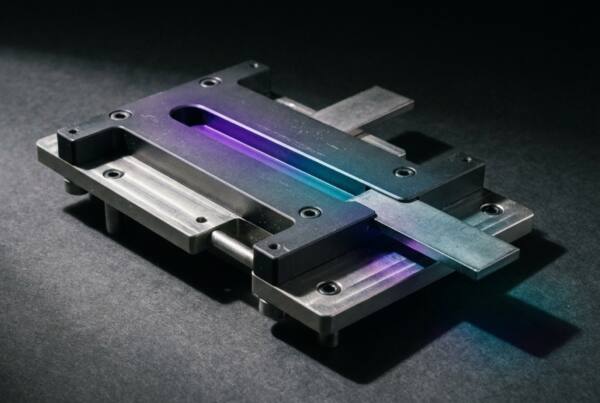
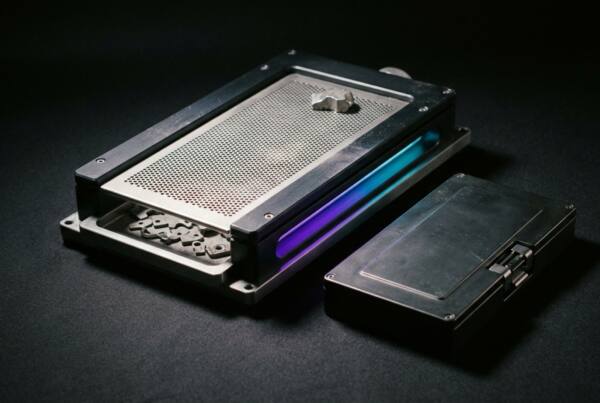
そこでルールを2層に分けました。光の性質(冷たく、暗く、物理的な作用の痕跡を残す)は固定し、光の現れ方(隙間から漏れる、壁に落ちる、すりガラスのような素材を抜ける、金属面に映り込む)は1枚ごとに変えています。

⭐ アイデンティティは繰り返しから生まれますが、繰り返すべきは性質です。形まで固定すると、5枚目あたりからテンプレートに見え始めます。

もう1つの越えない線

⛔ チームや顧客として人の顔を生成しない。実績として画面のスクリーンショットを生成しない。

生成した素材が受け持つのは、空気感と質感だけです。証拠には必ず本物を使います。これは美意識ではなく信頼の問題です。生成だと見抜かれた「顧客事例」が1枚あるだけで、隣に並ぶ本物まで一緒に価値を落とします。